192GB 통합 메모리는 ‘더 큰 AI 모델을 올릴 수 있다’는 뜻이지 ‘더 빠르다’는 뜻이 아니다. AMD 라이젠 AI 헤일로(495)의 메모리 대역폭은 273GB/s로, 128GB급 경쟁 기기와 비슷한 수준이다.
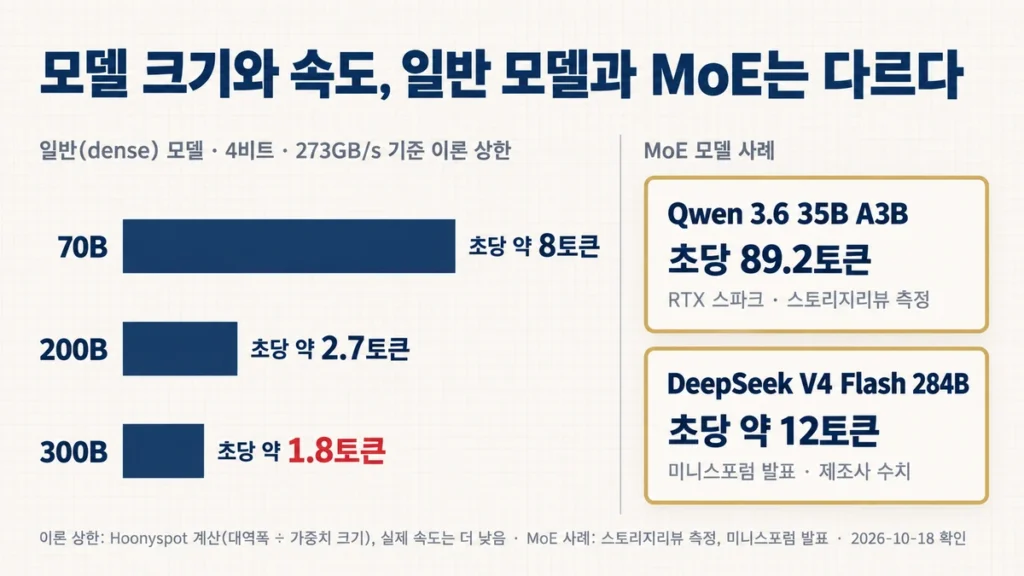
그래서 모든 매개변수를 매번 쓰는 300B급 일반(dense) 모델을 4비트로 올리면, 답이 나오는 속도는 단순 계산상 초당 2토큰을 넘기 어렵다. 같은 크기라도 일부만 골라 쓰는 MoE 모델은 훨씬 빠를 수 있다. 용량과 속도를 따로 봐야 하는 이유다.
이 글의 표기 기준
📌 확정 — 제조사 공식 발표나 실제 판매로 확인된 내용
📢 발표·주장 — 발표됐지만 출시 전이거나, 제조사가 직접 측정한 내용
🔎 분석 — 공개 자료를 바탕으로 한 Hoonyspot의 계산과 해석
성능 수치는 해외 전문 매체와 제조사가 측정한 값입니다. Hoonyspot이 직접 측정한 값이 아니며, 측정 조건을 함께 적었습니다.
128GB vs 192GB 통합 메모리, 무엇이 다른가
통합 메모리는 CPU와 GPU가 한 덩어리의 메모리를 나눠 쓰는 구조다. 일반 그래픽카드는 GPU 전용 메모리(VRAM)를 따로 갖고 있어서, 그 용량을 넘는 AI 모델은 한 번에 올리지 못한다.
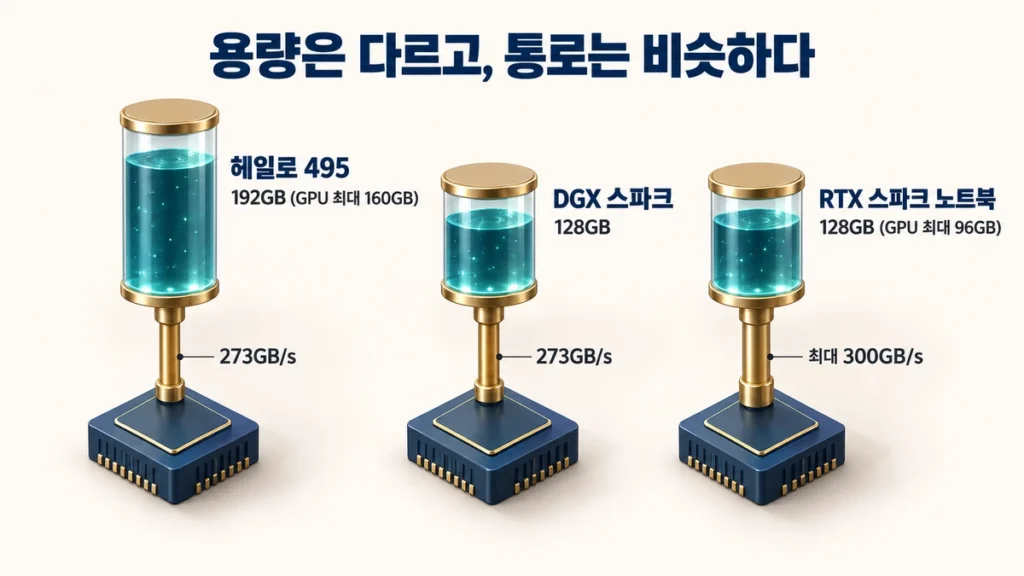
통합 메모리는 그 벽을 낮춘다. 대신 전용 VRAM보다 데이터를 나르는 속도, 즉 대역폭이 낮은 편이다. 로컬 AI PC를 고를 때 따져야 할 숫자가 용량과 대역폭 두 개인 이유다.
지금 128GB 이상 통합 메모리를 내세운 기기는 세 갈래다.
| 항목 | 라이젠 AI 헤일로 (495) | DGX 스파크 (128GB) | RTX 스파크 노트북 (128GB) |
|---|---|---|---|
| 형태 | 미니PC | 미니PC | 노트북 |
| 최대 메모리 | 192GB | 128GB | 128GB |
| GPU에 줄 수 있는 몫 | 최대 160GB | CPU·GPU 공유 | 최대 96GB (보고 기준) |
| 메모리 대역폭 | 273GB/s | 273GB/s | 최대 300GB/s |
| 운영체제 | 리눅스 (윈도우 모델 출시 예정) | 리눅스 | Arm용 윈도우 |
| AI 소프트웨어 | ROCm | CUDA | CUDA |
| 미국 가격 | 7,300달러 안팎 | 6,900달러대 (10월 2일 보도 기준) | 5,900달러 안팎 (서피스 128GB) |
출처: AMD·엔비디아 발표, 비디오카즈·톰스하드웨어·스토리지리뷰·더레지스터 보도 (2026-10-18 확인). 미국 가격은 판매세 별도.
표에서 눈에 띄는 건 대역폭 줄이다. 세 기기 모두 273~300GB/s 범위에 몰려 있다. 192GB 기기라고 데이터를 더 빨리 나르지는 않는다는 뜻이다.
다만 대역폭이 비슷하다고 실제 속도까지 같지는 않다. 연산 성능, 캐시, 추론 프로그램의 최적화 수준도 결과를 바꾼다. 아래 측정에서 RTX 스파크와 이전 세대 헤일로는 대역폭 차이가 크지 않은데도 작업 시간이 꽤 벌어졌다.
라이젠 AI 헤일로 495, 지금 어디까지 나왔나
AMD는 10월 12일 192GB 구성을 갖춘 새 라이젠 AI 헤일로를 발표했다. 이름에 ‘개발자 플랫폼’이 붙어 있지만, 신청제 개발 키트가 아니라 매장에서 파는 미니PC다. 📌
AMD 공식 헤일로 플랫폼은 미국 전자제품 매장 마이크로센터에서 리눅스 구성만 팔고 있다. AMD는 윈도우 구성도 곧 나온다고 밝혔지만 출시일은 발표하지 않았다. 같은 칩을 쓴 타사 제품도 나오고 있지만 아직 예약판매 단계인 곳이 많다. 한국 출시는 어느 쪽도 확인되지 않았다.
| 제품 | 현재 단계 | 국내 |
|---|---|---|
| AMD 라이젠 AI 헤일로 495 (리눅스) | ③ 미국 판매 중 (마이크로센터) 📌 | 미확인 |
| AMD 라이젠 AI 헤일로 495 (윈도우) | ② 출시 예정 발표, 출시일 미정 📢 | 미확인 |
| 미니스포럼 MS-S1 MAX-P495 | 예약판매, 10월 중순 출하 예정 (제조사 발표) 📢 | 미확인 |
| 프레임워크 데스크톱 192GB | 예약판매, 11월 출하 예정, 리눅스 전용 (제조사 발표) 📢 | 미확인 |
단계: ①유출 ②공식 발표 ③해외 출시 ④국내 출시 확정 ⑤국내 판매 · 2026-10-18 확인 기준
1달러=1,331.40원(10월 16일 서울 외환시장 종가)으로 단순 환산하면 7,300달러는 약 972만 원이다. 미국 표시가는 판매세가 빠진 값이고 국내 소비자가는 부가세 10%가 붙는다. 이 숫자를 국내 가격으로 볼 수는 없다.
이전 세대(395)와 비교하면 가장 큰 변화는 메모리 용량이다. CPU 16코어와 그래픽 40CU 구성은 그대로이고, 부스트 클럭이 5.1GHz에서 5.2GHz로, 메모리 속도가 조금 올랐다.
| 항목 | 헤일로 (395) | 헤일로 (495) |
|---|---|---|
| CPU / 그래픽 | 16코어 / 40CU | 16코어 / 40CU (동일) |
| 메모리 | 128GB | 192GB |
| 대역폭 | 약 256GB/s | 273GB/s |
| 미국 가격 | 4,000달러 안팎 | 7,300달러 안팎 |
출처: AMD 발표, 비디오카즈·릴리퓨팅 보도
출시 전 유출된 패스마크 점수에서도 CPU 차이는 4% 안팎이었다. 톰스하드웨어는 이 정도면 측정할 때마다 생기는 편차일 수 있다고 봤다. 가격은 1.8배가 됐다. 추가로 내는 3,300달러가 사는 것은 주로 64GB의 메모리다. 🔎
‘300B 모델 실행’이 뜻하는 것, 일반 모델과 MoE의 차이
AMD는 4비트 양자화 조건에서 3,000억(300B) 매개변수 이상의 모델을 돌릴 수 있다고 밝혔다. 📢 틀린 말은 아니다. 다만 ‘메모리에 올라간다’와 ‘쓸 만한 속도로 답한다’는 다른 이야기다.
AI 모델이 답을 한 토큰씩 만들 때마다 모델의 가중치를 메모리에서 읽어야 한다. 그래서 매번 읽는 가중치가 클수록, 대역폭이 낮을수록 느려진다. 모든 매개변수를 매번 쓰는 일반(dense) 모델이라면 이 관계로 이론상 최고 속도를 대략 계산할 수 있다.
| 일반(dense) 모델 크기 (4비트) | 가중치 크기 | 올릴 수 있는 기기 | 이론 상한 (273GB/s) |
|---|---|---|---|
| 70B | 약 35GB | 세 기기 모두 | 초당 약 8토큰 |
| 200B | 약 100GB | 192GB 기기 여유 / 128GB 기기 빠듯하거나 불가 | 초당 약 2.7토큰 |
| 300B | 약 150GB | 192GB 기기만 | 초당 약 1.8토큰 |
🔎 Hoonyspot 계산: 대역폭 ÷ 가중치 크기. 일반(dense) 모델을 한 번에 한 요청씩 일반적인 방식으로 실행한다는 가정의 이론 최대치이며, 실제 속도는 이보다 낮다. MoE 모델에는 적용되지 않는다.
초당 2토큰이면 한 문장을 받는 데 십수 초가 걸린다. 500토큰짜리 답 하나에 4분 넘게 기다려야 하는 셈이다.
메모리 여유도 생각보다 적다. 150GB는 4비트 가중치만의 단순 계산이다. 실제로는 양자화 부가정보, 대화 기록을 담는 KV 캐시, 실행 프로그램이 메모리를 더 쓴다. GPU에 최대 160GB를 줄 수 있어도, 모델에 따라 전부 올리기 어렵거나 다룰 수 있는 문맥 길이가 짧아질 수 있다.
MoE 모델은 사정이 다르다. MoE는 전체 매개변수 중 일부만 골라 쓰는 구조라, 매번 읽어야 할 양이 훨씬 적다. 예를 들어 Qwen 3.6 35B A3B는 한 번에 약 3B만 쓴다. 스토리지리뷰가 RTX 스파크(128GB)로 이 모델을 코딩 에이전트(Codex CLI, Ollama, 64K 문맥)에 붙여 측정했을 때 생성 속도는 초당 89.2토큰이었다.
192GB급에서도 같은 경향이 보인다. 495 탑재 미니PC를 내놓은 미니스포럼은 284B 크기의 MoE 모델(DeepSeek V4 Flash, 4비트)을 자사 제품 한 대로 초당 약 12토큰에 돌렸다고 발표했다. 📢 측정 조건이 공개되지 않은 제조사 수치지만, 모델의 전체 크기만으로 속도를 판단하면 안 된다는 점은 분명히 보여준다.
같은 AI 작업을 맡겼을 때의 결과
세 기기에 같은 작업을 맡긴 자료로는 톰스하드웨어의 AgentPerf-local 테스트가 있다. AI 코딩 에이전트가 실제 작업을 끝내는 데 걸린 시간을 쟀다. llama.cpp를 기기별로 소스에서 빌드했고, 4비트 양자화(Q4_K_M) 조건이다.
다만 추론 가속 방식은 기기마다 달랐다. Qwen 3.8 27B 작업에서 RTX 스파크와 맥북에는 DFlash2라는 추측 디코딩을, 헤일로에는 모델 자체의 MTP 기능을 썼다. 그래서 이 결과는 같은 작업을 맡긴 시스템 전체의 비교이고, 하드웨어 차이만 따로 떼어낸 실험은 아니다.
| 작업 모델 | RTX 스파크 (서피스) | 14인치 맥북 프로 M5 Max | 라이젠 AI 헤일로 (395) |
|---|---|---|---|
| Qwen 3.6 35B A3B (MoE) | 8분 | 10분 | 13분 |
| Qwen 3.8 27B (일반) | 기준 | 약 25% 더 걸림 | 약 40분 (약 2배) |
출처: 톰스하드웨어. 세 기기 모두 128GB 구성. 굵은 글씨가 가장 빠른 쪽이다.
여기서 헤일로는 192GB 신형(495)이 아니라 128GB 이전 세대(395)다. 495로 같은 측정을 한 주요 매체 자료는 아직 확인되지 않았다. 다만 495의 연산 구성이 395와 같고 클럭과 대역폭이 조금 오른 정도라, 이 순위가 크게 뒤집힐 근거는 아직 없다. 🔎
AMD가 내놓은 자체 비교도 있다. 이미지 생성 작업(ComfyUI)에서 495가 64GB 메모리의 경쟁 노트북보다 최대 30배 넘게 빨랐다는 주장이다. 📢 비교 대상의 메모리가 3분의 1이라, 모델이 메모리에 다 들어가느냐 아니냐의 차이로 읽는 게 맞다. 같은 용량끼리의 속도 비교는 아니다. 🔎
하드웨어보다 먼저 갈리는 것, 소프트웨어
세 기기는 AI를 돌리는 소프트웨어 기반이 다르다. 이미 쓰고 있는 도구가 무엇이냐에 따라 선택지가 먼저 좁혀진다.
- CUDA로 짠 코드를 그대로 써야 한다면 — DGX 스파크나 RTX 스파크다. 헤일로는 AMD의 ROCm을 쓰므로 CUDA 전용 도구는 돌아가지 않는다.
- 리눅스 서버처럼 켜두고 쓸 거라면 — DGX 스파크와 헤일로 리눅스 모델이 맞는다.
- 윈도우 프로그램과 함께 들고 다녀야 한다면 — RTX 스파크 노트북뿐이다. 다만 Arm용 윈도우라 일부 프로그램은 에뮬레이션으로 돈다.
- x86 윈도우가 꼭 필요하다면 — AMD 공식 헤일로 플랫폼의 윈도우 구성은 아직 출시일이 발표되지 않았다. 495를 쓴 타사 제품은 업체별로 운영체제 구성이 다르니 따로 확인해야 한다.
ROCm은 리눅스와 윈도우를 모두 지원한다고 AMD는 밝혔다. 📢 톰스하드웨어도 헤일로 측정에 ROCm용 llama.cpp를 썼다. llama.cpp나 LM Studio처럼 여러 기기를 지원하는 도구만 쓴다면 이 차이는 작아진다.
로컬 AI PC 고르는 기준
정리하면 판단 순서는 이렇다. 먼저 돌릴 모델의 크기를 정하고, 그 다음 소프트웨어, 마지막으로 폼팩터를 본다.
| 주로 돌릴 모델 | 판단 🔎 |
|---|---|
| 14B 이하 | 통합 메모리 기기가 필요 없다. 16~24GB 그래픽카드가 더 빠르다 |
| 30B급 MoE, 70B급 일반 모델 하나 | 대체로 128GB로 충분하다 |
| 여러 모델 동시 실행, 긴 문맥, 이미지·음성 모델 병행 | 192GB의 추가 메모리가 유리해지는 구간 |
| 200B~300B급 대형 모델 실험 | 192GB가 필요하다. 일반 모델이면 초당 몇 토큰 수준을 감수해야 하고, MoE 모델이면 더 빠를 수 있다 |
RTX 스파크 노트북의 국내 출시 현황과 측정값은 RTX 스파크 노트북 국내 출시 글에 따로 정리했다.
이런 경우엔 안 사도 된다
• 로컬 AI를 가끔만 쓴다면 — 128GB 이상 구성은 미국 가격만 6천 달러 안팎이다. 데이터를 외부로 보낼 수 없는 사정이 없다면 클라우드 AI 구독이 훨씬 싸다.
• 70B 이하 모델 하나만 돌린다면 — 대체로 128GB로 충분하다. 여러 모델을 동시에 띄울 계획이 없다면 128GB 기기가 더 싸거나 더 빠르다.
• 국내 AS가 중요하다면 — 헤일로 495는 국내 출시가 확인되지 않았다. 직구 미니PC는 고장 시 해외 배송이 필요할 수 있다.
• 윈도우가 필요하다면 — AMD 공식 헤일로 플랫폼의 윈도우 구성은 아직 출시일이 없다. 리눅스 구성을 사서 바꿔 쓰기보다 출시를 기다리는 편이 낫다.
• 속도가 목적이라면 — 대형 모델 생성 속도는 대역폭이 높은 기기가 유리하다. 메모리 용량만 보고 고르면 기대와 다를 수 있다.
핵심 요약
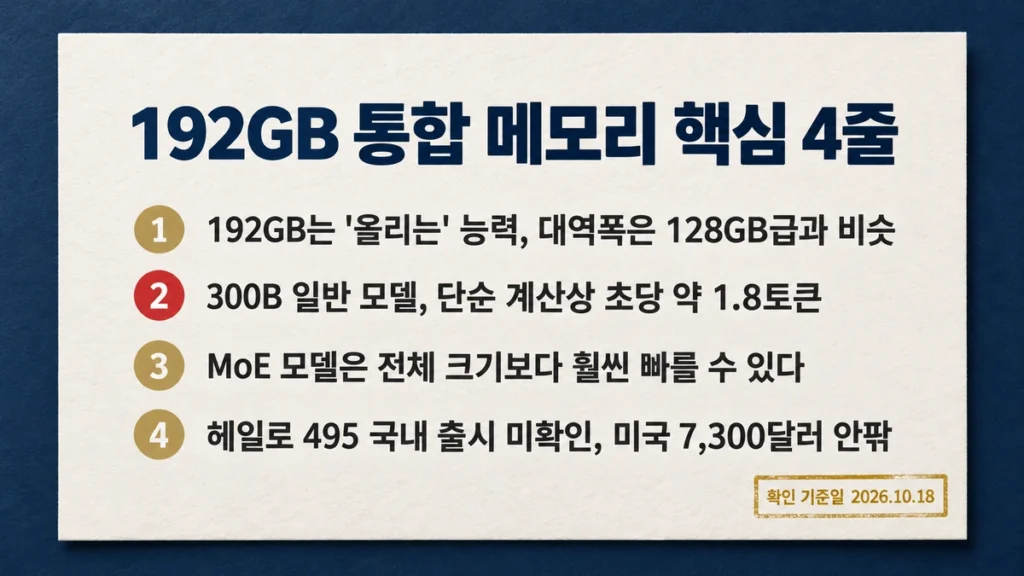
- 192GB 통합 메모리는 더 큰 모델을 ‘올리는’ 능력이다. 대역폭은 273GB/s로 128GB급 기기와 비슷하다.
- 300B급 일반(dense) 모델을 4비트로 올리면 단순 계산상 초당 2토큰을 넘기 어렵다. 일부만 쓰는 MoE 모델은 훨씬 빠를 수 있어, 전체 크기만으로 속도를 판단하면 안 된다.
- 헤일로 495는 395 대비 연산 구성이 같고, 가장 큰 변화는 메모리 64GB 증가다. 미국 가격은 약 1.8배다.
- AMD 공식 헤일로 495는 미국 마이크로센터에서 리눅스 구성만 판매 중이고, 타사 제품은 예약판매 단계가 많다. 국내 출시는 확인되지 않았다.
자주 묻는 질문
Q. 192GB 통합 메모리면 그래픽카드 VRAM 192GB와 같은 건가요?
아닙니다. GPU에 줄 수 있는 몫은 최대 160GB이고, 나머지는 CPU와 운영체제가 씁니다. 대역폭도 고성능 그래픽카드의 전용 VRAM보다 낮아서, 같은 모델을 돌리면 속도가 느립니다.
Q. 라이젠 AI 헤일로 495를 국내에서 살 수 있나요?
2026년 10월 18일 기준으로 국내 출시는 확인되지 않았습니다. AMD 공식 헤일로 플랫폼은 미국 마이크로센터에서 리눅스 구성만 팔고 있습니다. 같은 칩을 쓴 미니스포럼·프레임워크 제품은 해외 예약판매 단계이고, 국내 정식 판매 여부는 확인되지 않았습니다.
Q. 이미 헤일로 395(128GB)를 쓰고 있는데 바꿀 만한가요?
128GB에 안 들어가는 모델을 꼭 돌려야 하는 경우가 아니라면 바꿀 이유가 적습니다. 연산 구성이 같아서 지금 돌리는 모델의 속도는 크게 달라지지 않습니다.
참고 자료
- AMD — 라이젠 AI 헤일로 발표·제품 사양 (amd.com)
- 마이크로센터 — 라이젠 AI 헤일로 495 판매 페이지 (microcenter.com)
- 비디오카즈 — 495 출시·가격·대역폭 (videocardz.com)
- 톰스하드웨어 — 로컬 AI 에이전트 측정, 495 유출 점수 (tomshardware.com)
- 스토리지리뷰 — RTX 스파크 로컬 AI 측정 (storagereview.com)
- 더레지스터 — DGX 스파크 가격 (theregister.com)
- 릴리퓨팅 — 이전 세대 헤일로 가격 (liliputing.com)
- 미니스포럼 — MS-S1 MAX-P495 발표 (minisforum.com)
- 프레임워크 — 192GB 데스크톱 예약판매 공지 (frame.work)
확인 기준일: 2026년 10월 18일. 표의 이론 속도는 Hoonyspot의 단순 계산이며 실제 측정값이 아닙니다. 메모리 가격 변동으로 각 기기의 가격이 바뀔 수 있으니, 구매 전 판매처 가격을 다시 확인해 주세요.