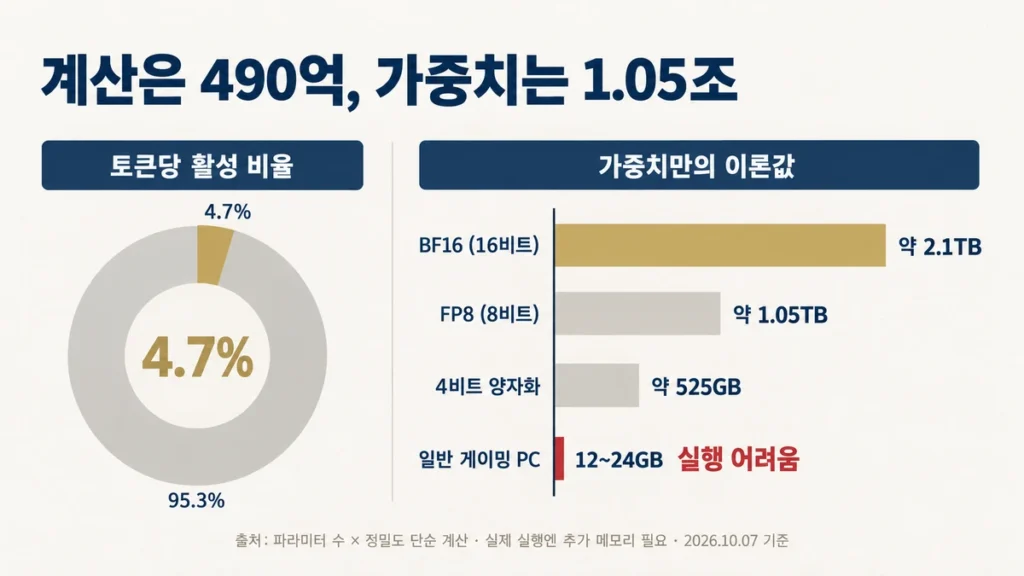
Mistral Large 4의 총 파라미터는 1.05조 개다. 그런데 단어 조각 하나(토큰)를 처리할 때 실제로 계산에 쓰이는 건 490억 개, 전체의 약 4.7%뿐이다. 이 차이를 만드는 구조가 MoE(Mixture of Experts, 전문가 혼합)다.
프랑스 Mistral AI가 2026년 10월 6일 이 모델을 공개했다. 별칭은 ‘Le Chonk’다. 다만 “1조 파라미터”를 그대로 성능 숫자로 읽으면 몇 군데에서 오해가 생긴다. 공식 문서로 확인된 것, 발표만 된 것, 해석을 나눠 정리했다.
3줄 요약
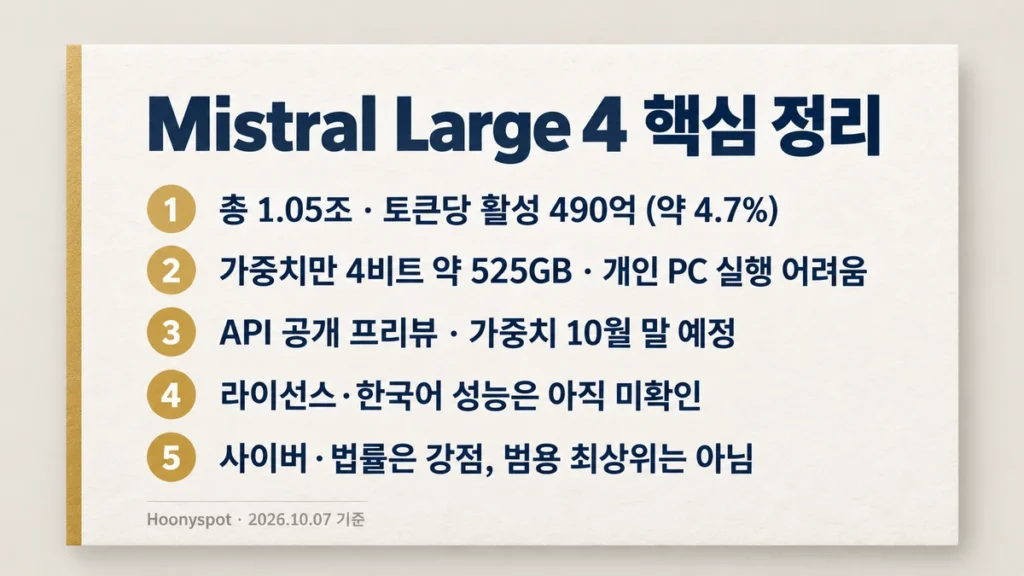
① 총 1.05조 개 중 토큰당 490억 개만 활성화됩니다. 그래서 1.05조 개를 매번 전부 계산하는 밀집 모델보다 연산 부담이 크게 줄어듭니다.
② 대신 가중치는 1.05조 개 전체가 필요합니다. 4비트로 줄여도 가중치만 약 525GB라 개인 PC로는 실행이 어렵습니다.
③ 지금은 API 공개 프리뷰 단계입니다. 가중치는 10월 말 공개 예정이고, 라이선스는 아직 발표되지 않았습니다.
표기 기준 — 📌 확정: 공식 문서로 확인 / 📢 발표: 회사가 예고했으나 아직 시행 전 / 🔎 분석: 추정 또는 Hoonyspot 해석 (2026년 10월 7일 확인)
Mistral Large 4, 공식 문서로 확인된 사양
Mistral 공식 블로그, 개발자 문서의 모델 카드, 허깅페이스 공개 예정 페이지를 대조했다. 세 곳의 숫자가 조금씩 달라서 표에 집계 기준까지 함께 적었다.
| 항목 | 내용 | 상태 |
|---|---|---|
| 총 파라미터 | 1.05조 (블로그는 ‘1조’로 반올림 표기) | 📌 |
| 활성 파라미터 | 토큰당 490억 (임베딩·출력층 포함 시 520억) | 📌 |
| 구조 | 세분화된 MoE, 지시 수행과 추론을 한 모델에 통합 | 📌 |
| 입력·출력 | 텍스트와 이미지 입력, 텍스트 출력 (비전 인코더 16억) | 📌 |
| 컨텍스트 | Mistral 문서 100만 토큰 / 외부 측정 51만~52만 토큰 | ⚠️ |
| 학습 | 유럽 자체 데이터센터, 엔비디아 Grace Blackwell GPU 3,800개, 처음부터 학습 | 📌 |
| 언어 | 160개 이상, EU 공식 언어 전부 포함 (한국어 명시 없음) | 📌 |
| 현재 상태 | API 공개 프리뷰 (강화학습이 아직 진행 중) | 📌 |
| 가중치 공개 | 10월 말 예정 (언론 보도 27일, 허깅페이스 예정일 31일) | 📢 |
| 라이선스 | 미공개 | ❓ |
숫자가 갈리는 이유는 단순하다. ‘1조’와 ‘1.05조’는 반올림 차이다. ‘490억’과 ‘520억’은 단어 사전 역할을 하는 임베딩층을 셈에 넣느냐의 차이다. 기사마다 숫자가 다르게 보이는 건 대부분 이 두 가지 때문이다.
컨텍스트는 성격이 다르다. Mistral 공식 사양은 100만 토큰이지만, Artificial Analysis와 OpenRouter는 현재 약 52만 토큰으로 표시한다. 측정·서비스 환경의 차이인지, 프리뷰 단계의 제한인지는 확인되지 않았다. 긴 문서를 통째로 넣을 계획이라면 쓰려는 경로의 최대 입력 길이를 먼저 확인하는 편이 안전하다.
1조 파라미터인데 실제로 쓰는 건 490억인 이유
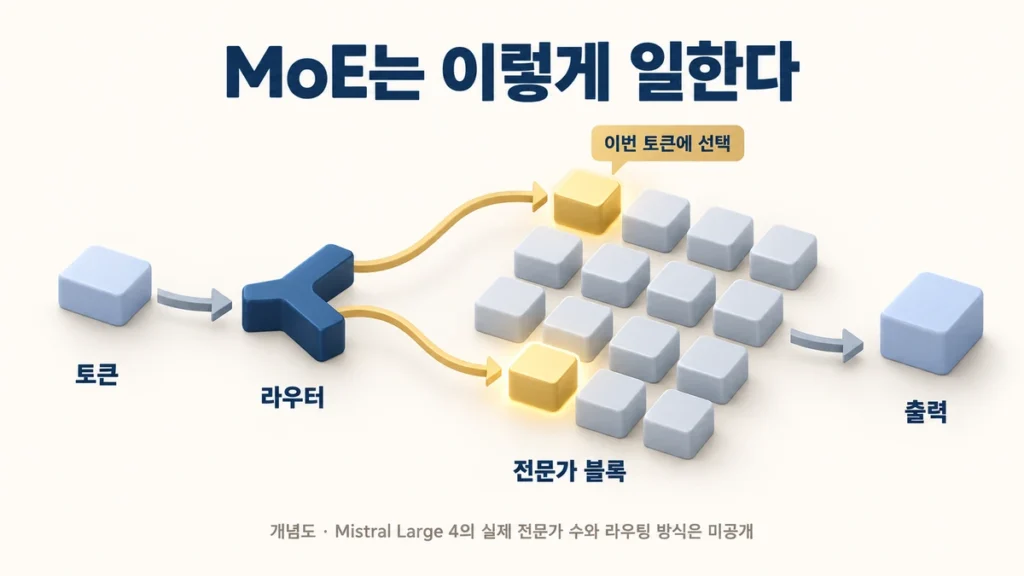
기존 ‘밀집(dense)’ 모델은 토큰 하나를 처리할 때 모든 파라미터를 다 계산한다. MoE는 다르다. 모델 안에 여러 개의 ‘전문가’ 블록을 두고, 라우터가 토큰마다 필요한 전문가 몇 개만 골라 일을 시킨다.
원리는 Mistral이 2024년에 낸 Mixtral 논문에 잘 나와 있다. Mixtral 8x7B는 층마다 전문가 8개를 두고 토큰당 2개만 불렀다. 그 결과 모델이 쓸 수 있는 파라미터는 470억 개인데, 토큰 하나에 실제로 계산하는 건 130억 개였다. Large 4도 같은 계열의 구조다. 다만 전문가 개수와 라우팅 방식은 아직 공개되지 않았고, 가중치 공개 때 발표할 예정이다.
병원으로 비유하면
전문의 1,000명이 있는 대형 병원을 떠올리면 된다. 환자(토큰)가 오면 접수창구(라우터)가 증상에 맞는 의사 몇 명만 부른다. 병원 전체가 아는 범위는 1,000명분이지만, 한 번 진료에 드는 인건비(연산)는 몇 명분이다. 대신 1,000명 모두 병원에 상주해야 하니 건물(메모리)은 1,000명분이 필요하다.
계산은 490억, 메모리는 1.05조
MoE에서 가장 자주 생기는 오해가 여기다. 활성 파라미터가 490억이라고 가중치도 490억 개만 저장하면 되는 건 아니다. 어떤 토큰이 어떤 전문가를 부를지 미리 알 수 없어서, 빠르게 돌리려면 1.05조 개 전체에 바로 접근할 수 있어야 한다. 보통 여러 GPU에 나눠 올린다. 일부를 CPU 메모리나 저장장치로 내려 둘 수도 있지만, 그만큼 속도가 떨어진다.
그래서 MoE의 이득은 ‘연산’에서 나온다. 1.05조 개를 매 토큰마다 계산하지 않으니, 전체를 다 쓰는 밀집 모델보다 필요한 연산이 크게 줄어든다. 다만 어텐션·라우터 같은 구성 요소가 따로 있어서, 활성 파라미터 숫자만으로 490억짜리 밀집 모델과 연산량이 같다고 볼 수는 없다. 참고로 Artificial Analysis는 Mistral API에서 초당 116토큰을 측정했다. 반면 필요한 하드웨어는 크게 줄지 않는다. 가중치만 따로 계산하면 아래와 같다.
| 정밀도 | 가중치만의 이론값 🔎 | 현실적인 환경 🔎 |
|---|---|---|
| BF16 (16비트) | 약 2.1TB | 데이터센터 다중 서버 |
| FP8 (8비트) | 약 1.05TB | 최신 GPU 8장급 서버 |
| 4비트 양자화 | 약 525GB | 80GB GPU 8장 등 서버급 |
| 일반 게이밍 PC | GPU 메모리 12~24GB | 사실상 불가능 |
※ 파라미터 수 × 정밀도별 바이트로 계산한 가중치만의 이론적 최소 용량이다. 실제 추론에는 KV 캐시·활성값·양자화 메타데이터·런타임 공간이 추가로 필요하고, 그 양은 컨텍스트 길이·배치 크기·실행 방식에 따라 크게 달라진다.
1조 파라미터도 더 이상 최대 규모는 아니다
2026년 오픈웨이트 최상위권에서 1조 파라미터는 더 이상 최대 규모가 아니다. 중국 모델들은 이미 2조를 넘겼다. 같은 MoE끼리 나란히 놓으면 Large 4의 위치가 보인다.
| 모델 | 총 파라미터 | 활성 파라미터 | 활성 비율 | 가중치 |
|---|---|---|---|---|
| Mistral Large 4 | 1.05조 | 490억 | 약 4.7% | 10월 말 예정 |
| Mistral Large 3 | 6,750억 | 410억 | 약 6.1% | 공개 (Apache 2.0) |
| DeepSeek V4 Pro | 1.6조 | 490억 | 약 3.1% | 공개 (MIT) |
| Qwen3.8-2.4T-A95B | 2.4조 | 950억 | 약 4% | 공개 (자체 라이선스) |
| Kimi K3 | 2.8조 | 1,040억 | 약 3.7% | 공개 (자체 라이선스) |
※ Mistral·DeepSeek·Qwen은 각 사 공식 자료, Kimi K3는 복수 매체 보도 기준. Qwen3.8-Max는 이 오픈웨이트 모델을 바탕으로 기능을 더한 공식 서비스 버전이다. 활성 비율은 활성÷총 파라미터로 직접 계산했다. 2026년 10월 7일 확인.
눈여겨볼 줄은 DeepSeek V4 Pro다. 총 크기는 1.6조로 Large 4보다 크지만, 토큰당 활성 파라미터는 490억으로 똑같다. 계산 체급은 같은데 전체 크기가 다른 셈이다. 총 파라미터가 2배 넘는 Kimi K3나 Qwen3.8-2.4T-A95B가 모든 지표에서 Large 4를 앞서는 것도 아니다. 성능은 숫자 크기보다 학습 데이터와 학습 방식, 라우팅 설계에 더 크게 좌우된다.
회사 성적표와 외부 성적표
Mistral이 낸 벤치마크와 외부 기관이 잰 결과를 따로 놓고 봐야 한다. 회사 발표 수치는 대부분 측정 조건이 공개되지 않았다. 외부 평가는 조건이 공개돼 있지만, 강화학습이 아직 진행 중인 프리뷰 모델을 잰 결과다.
| Mistral 발표 (회사 주장) | 외부 독립 평가 |
|---|---|
| 코딩 DeepSWE v1.1 61.7% | Artificial Analysis 지능 지수 38점. 미국·중국 밖 모델 중 최고 |
| 사이버보안 Cybench 93% | 같은 기관 평가: 지능이 비슷한 중국 오픈웨이트 모델보다 작업당 비용 4배 이상 |
| 업무 자동화 AutomationBench 59.9% | Vals 종합 지수 48.05%, 44개 모델 중 32위 |
| CEO: “사이버 등 일부 영역에서 중국 모델보다 위” | Vals 법률 에이전트 평가 15.83%, 75개 모델 중 6위 |
CEO 아르튀르 멘슈(Arthur Mensch)의 발언은 Reuters가 전했다. 같은 기사는 그가 어떤 중국 모델을, 어떤 기준으로 앞섰는지는 밝히지 않았다고 덧붙였다. 외부 평가를 종합하면 그림이 선명해진다. 🔎 사이버보안, 법률, 문서·이미지 이해 쪽은 강하다. 반면 종합 평가는 기관마다 차이가 커서, 지금의 프리뷰 결과만으로 최상위 범용 모델이라고 보기는 어렵다. ‘1조’라는 숫자에서 기대하는 압도적 1위 모델은 아니다.
오픈웨이트라는데 아직 내려받을 수 없다
Large 4는 ‘오픈웨이트 모델’로 소개되지만, 지금 당장 가중치를 받을 수는 없다. 현재 단계는 발표와 API 공개 프리뷰다. 📢 가중치는 10월 말 공개가 예고됐고, 정식 출시 시점은 정해지지 않았다.
📌 API 정가는 100만 토큰당 입력 1.36달러, 출력 4.18달러다. Mistral 공식 변경 내역에 따르면 출시 후 2주간은 50% 할인이 적용돼 입력 0.68달러, 출력 2.09달러다(2026년 10월 7일 확인). 예산을 잡을 때는 할인이 끝난 정가 기준으로 계산하는 편이 안전하다.
라이선스는 가장 큰 미확인 항목이다. 직전 모델 Large 3는 상업 이용이 자유로운 Apache 2.0이었다. 하지만 이번에는 자체 라이선스가 예상된다는 보도가 나왔다. 상업적으로 쓸 계획이라면 Large 3 조건을 그대로 기대하지 말고, 공개 시점의 라이선스 문서를 먼저 확인해야 한다.
한 가지 더 있다. 가중치 공개 전까지 사이버보안 기업, 검증된 파트너, 정부 기관은 제한을 완화한 별도 버전을 쓴다. 일반 API 사용자가 쓰는 모델과 같은 버전이 아니라는 뜻이다.
한국에서 쓰려면 확인할 네 가지
한국어 성능 — 공식 자료에 한국어가 명시돼 있지 않고, 한국어 벤치마크도 없습니다. ‘160개 이상 언어’는 학습 범위이지 품질 보장이 아닙니다.
이용 지역 — Mistral 리전 문서에는 글로벌·EU·미국 엔드포인트만 있습니다. 한국을 지원 국가로 명시한 문서는 찾지 못했습니다.
접근 경로 — 현재는 Mistral 자체 API와 일부 서드파티 중개 서비스로 쓸 수 있습니다. Azure·AWS Bedrock·Google Vertex 제공은 확인되지 않았습니다.
챗봇 앱 — Mistral 챗봇 Vibe(옛 Le Chat, 2026년 5월 말 개명)에 Large 4가 적용됐는지는 공식 발표에서 확인되지 않았습니다.
Hoony가 본 Mistral Large 4
🔎 이 모델의 의미는 ‘1조’라는 크기보다 위치에 있다. 미국과 중국 밖에서 나온 오픈웨이트 모델 중 가장 높은 외부 평가를 받았고, 유럽 데이터센터에서 학습하고 서빙한다. 데이터를 미국·중국 기업 인프라에 맡기기 어려운 유럽 공공기관과 기업에는 실질적인 선택지가 생긴 것이다.
Mistral은 9월에 30억 유로 규모의 시리즈 D 투자를 유치했고, 삼성전자도 주요 투자자로 참여했다. Large 4는 Mistral이 이 자금으로 추진하는 모델 로드맵의 첫 결과물이다. 한국과도 무관한 이야기는 아니다.
반면 한국의 개인 사용자에게 당장 달라지는 건 크지 않다. 한국어 성능은 검증되지 않았고, 로컬 실행은 서버급 장비가 필요하며, 비용 효율은 중국 모델에 밀린다. 10월 말에 볼 것은 세 가지다. 가중치가 예고대로 나오는지, 라이선스가 어떤 조건인지, 최종 모델의 외부 평가가 프리뷰보다 오르는지다.
자주 묻는 질문
Q. 1조 파라미터면 GPT나 Claude보다 똑똑한가요?
파라미터 수와 성능은 비례하지 않습니다. Artificial Analysis 지능 지수에서 Large 4는 38점으로, 미국 최상위 폐쇄형 모델들보다 낮은 구간에 있습니다. 강점은 사이버보안·법률 같은 특정 영역에서 나타납니다.
Q. 지금 무료로 써볼 수 있나요?
현재는 유료 API 프리뷰로 제공됩니다. Mistral 챗봇 앱 탑재 여부는 공식 발표가 없어, 무료 체험 경로는 확인되지 않았습니다.
Q. 가중치가 공개되면 제 PC에서 돌릴 수 있나요?
어렵습니다. 4비트로 압축해도 가중치만 약 525GB가 필요합니다. 일반 그래픽카드 메모리(12~24GB)로는 실행할 수 없고, 서버급 GPU 여러 장이 필요합니다.
Q. 한국어는 잘하나요?
공식 자료에 한국어가 명시돼 있지 않고 한국어 벤치마크도 없습니다. 한국어 업무에 쓰실 계획이라면 실제 문서로 먼저 테스트해 보시길 권합니다.
이 글은 2026년 10월 7일까지 공개된 자료를 기준으로 작성했습니다. Mistral Large 4는 프리뷰 단계라 사양·가격·성능이 예고 없이 바뀔 수 있습니다. 벤치마크 수치는 측정 조건에 따라 달라지며, 메모리 수치는 단순 계산에 따른 추정입니다.
참고 자료
Mistral AI 공식 블로그 「Introducing Mistral Large 4」 — mistral.ai
Mistral 개발자 문서, Mistral Large 4 모델 카드 — docs.mistral.ai
Mistral 개발자 문서, 변경 내역(출시 할인) — docs.mistral.ai
Hugging Face, Mistral Large 4 공개 예정 페이지 — huggingface.co
Mixtral of Experts 논문 (arXiv 2401.04088) — arxiv.org
Artificial Analysis, Mistral Large 4 평가 — artificialanalysis.ai
Vals AI, Mistral Large 4 벤치마크 — vals.ai
Reuters, Mistral CEO 발언 보도 (2026-10-06) — reuters.com